Att bygga rätt saker
När allt går snabbare är det lättare än någonsin att springa åt fel håll. Så här använder vi agenter i research, kundinsikter och prototyper för att hitta rätt riktning.
I förra artikeln i serien gick vi igenom hur agenter bygger saker på rätt sätt, det som produktteam ofta kallar delivery (att bygga och leverera). Den här artikeln handlar i stället om att bygga rätt saker, alltså discovery (att ta reda på vad som är värt att bygga innan du bygger det), så att du får den effekt du vill ha.
För när det går snabbare att bygga går det också snabbare att bygga fel saker. Förut gav själva bygget lite betänketid. Medan teamet byggde hann produktägare och designers prata med kunder och fundera på nästa steg. Nu går bygget så fort att den tiden nästan försvinner. I förra artikeln såg vi hur flaskhalsen flyttade till granskningen. Här flyttar den till att förstå kunderna. Därför har discovery-arbetet aldrig varit viktigare, och det behöver anpassas till ett agentiskt arbetssätt så att det inte bromsar resten av produktteamet.
User research, kundintervjuer och att se hur produkten faktiskt används avgör fortfarande om du löser rätt problem på rätt sätt. Agenterna ersätter inte det arbetet, men de kan hjälpa dig att göra det snabbare och mer noggrant.
En invändning vi ofta hör: om det går så snabbt att bygga, kan vi väl bara ändra tills det blir rätt?
Ja, vi håller med. På ett hobbyprojekt som du har byggt själv i garderoben stämmer det. Så länge du är ensam användare funkar argumentet. Men när produkten är i drift och har riktiga användare (förutom du själv) kan saker snabbt bli mycket svårare att ändra i efterhand. En migrering av användardata går ofta inte att backa.
Ett enklare exempel är en ändring som skickar iväg 20 000 mejl till dina kunder. De mejlen går inte att ta tillbaka. Och om något gör att dina kunder tappar förtroendet, bygger du inte tillbaka det med en ny version.
Vi delar upp beslut på samma sätt som ändringarna i förra artikeln: i envägsdörrar och tvåvägsdörrar. Liknelsen kommer från Matt Pococks skill /pr, som beskriver en pull request (ett förslag på ändring som någon granskar innan det går in i koden). En tvåvägsdörr är billig att backa ut ur. En envägsdörr går inte att backa, till exempel migreringen och mejlutskicket ovan, eller något annat beslut som är svårt att ta tillbaka.
Till dörren hör påverkansgrad (blast radius). Den beskriver vad som kan gå sönder om beslutet visar sig vara fel: en layout som förskjuts, andra system som är beroende av ett API (gränssnittet som andra program pratar med) eller hur produkten fungerar i mobilen. Tillsammans gör dörren och påverkansgraden frågan “är det här säkert?” till ett tydligt påstående i stället för en magkänsla, och någon annan kan säga emot. De visar också var du ska lägga din egen tid.
Bakom tvåvägsdörrar med låg påverkansgrad fungerar det bra att bygga snabbt och ändra. Envägsdörrar, och beslut som kan påverka mycket, förtjänar mer research och eftertanke först.
Explorer: hitta det vi inte ska bygga
Snabbare byggen påverkar också vem som gör vad. Boris Cherny, som skapade Claude Code, beskriver fem arketyper han ser i sitt team: Prototyper, Builder, Sweeper, Grower och Maintainer. Arketyperna följer inte yrkestitlarna, och de flesta rör sig mellan två eller tre av dem. En designer kan vara den som bygger, en utvecklare den som utforskar.
Namnet Prototyper är dock snävt. Vi skulle hellre kalla rollen Explorer, utforskare, och låta den rymma hela discovery-arbetet, allt som produkt- och UX-research gör i dag. Utforskarens viktigaste uppgift är att ta reda på vad vi inte ska bygga. Det gör den genom att förstå användarnas och kundernas behov, se hur användarna faktiskt beter sig och klargöra vilket värde vi ska skapa. Själva prototyperna är ett av verktygen, inte målet.
Ett tankesätt som hjälper utforskaren är first principles thinking, att resonera utifrån grundprinciper. Du bryter ner ett komplext problem till grundläggande sanningar som inte går att ifrågasätta, och bygger sedan lösningen från grunden. Motsatsen är att resonera genom analogi, alltså att kopiera vad andra gör: konkurrenten har en dashboard, så då behöver vi också en. När du skalar bort vanor och antaganden kan du i stället ta fram ett nytt svar som utgår från vad användarna faktiskt behöver.
I det utforskande arbetet använder vi skills (instruktioner som agenten kan köra) för:
- designprinciper och UX-design
- designsprintar och double diamond
- user research och co-design med användare
- strategiskt tänkande
- prioritering utifrån kund- och användarbehov
Resten av artikeln handlar om hur agenterna kan hjälpa till där.
Agenter i det utforskande arbetet
Agenterna hjälper till på tre sätt:
- Syntes med granskning. En agent går igenom underlaget och föreslår teman. Underlaget kan vara kvalitativa kundinsikter som kundsamtal, intervjuer och supportärenden, eller kvantitativa som enkätsvar och NPS (hur gärna kunderna rekommenderar produkten). Det kan också vara användarinsikter från användningstester och data om hur produkten används. En annan agent kontrollerar sedan varje tema mot källorna. Finns det citat eller siffror som bär temat, eller hittade den första agenten bara det den letade efter? Starkast är teman som syns i flera källor. Ett exempel: kunder säger i samtal att det är svårt att komma igång, och användningsdata visar att många aldrig slutför sin första uppladdning. Teman utan stöd skickas tillbaka.
- Antaganden blir en researchplan. När skills som Matt Pococks
/grill-with-docsfrågar ut dig om planen kan agenten också lista vilka antaganden lösningen vilar på, och vilka som är mest riskabla om de visar sig vara fel. De mest riskabla undersöker du först, innan något byggs på riktigt. - Effekten styr nästa varv. Efter lansering kan en agent jämföra data, supportärenden och feedback med effekten du bestämde från början, alltså det som arbetet ska förändra för användarna, och föreslå vad nästa varv (nästa produktiteration) ska handla om. Det agenten producerar, som rader kod och antal ändringar, är lätt att mäta och lätt att ta för produktivitet. Men som Kent Beck, en av grundarna av extreme programming och agil utveckling, påpekar i ett föredrag visar sådana mått bara insatsen. De säger ingenting om ifall användarna gör något annorlunda.
Siffror och samtal tillsammans
Mycket av det vi har beskrivit hittills är kvalitativt: samtal, intervjuer och observationer. Men agenterna är minst lika användbara i kvantitativ research. De kan ta fram data om hur produkten används, räkna på enkätsvar och följa hur många som tar sig igenom ett flöde och var de hoppar av. Be agenten skriva databasfrågan eller skriptet som tar fram siffran, i stället för att bara ge dig siffran. Då kan du köra det igen, och en annan agent kan granska hur siffran räknades fram.
Styrkan kommer när du kombinerar kvalitativt och kvantitativt, det som kallas mixed methods (där metoderna prövar varandra). Kvantitativ data visar vad som händer och hur många det gäller. Kvalitativ data förklarar varför. Ser du att många hoppar av i ett visst steg vet du var du ska titta, men inte varför. Några samtal med användare som hoppade av ger ofta svaret. Det fungerar åt andra hållet också: ett mönster du hör i intervjuer kan du sedan mäta, för att se om det gäller tre personer eller tretusen.
Förut var det dyrt att göra båda, så ofta fick det bli det ena. När agenterna sköter mycket av grovjobbet går det att låta siffror och samtal pröva varandra i varje varv. Agenterna kan dessutom läsa koden och väga in vad en ändring skulle kosta. Med supportärenden, kundsamtal och koden sida vid sida blir det lättare att prioritera: vad gör mest nytta för flest, och vad är en tvåvägsdörr som är billig att prova?
Anonymisera innan något lämnar datorn
Kundsamtal, inspelade användningstester, intervjuer och kvantitativ data om hur produkten används innehåller ofta personuppgifter. Innan de skickas till en agent i molnet är det viktigt att anonymisera uppgifterna, eller åtminstone pseudonymisera dem (namn och detaljer utbytta mot koder, med nyckeln förvarad för sig). Det gäller alla molntjänster där du skickar informationen till någon annan, inte bara AI. Transkriberingstjänster, enkätverktyg och delade dokument hör också dit. Det handlar om respekt för människorna som ställt upp, om vad de faktiskt har samtyckt till och om ansvaret för personuppgifter, som forskningsetik och GDPR reglerar.
Även här hjälper agenterna till. En lokal agent (som vi kallar Gate), som körs på din egen dator, går igenom materialet och byter ut namn, arbetsplatser och andra detaljer som kan peka ut en person. Sedan kontrollerar ett deterministiskt verktyg att inget slunkit igenom. Ett exempel är en linter, ett program som söker igenom text efter bestämda mönster: e-postadresser, telefonnummer, personnummer och namn från en lista. Den gör samma kontroll varje gång, oberoende av en modells omdöme. Hittar lintern något går materialet ett varv till. Det är samma upplägg som i förra artikeln: en som gör, en som granskar, och du som stickprovar innan något lämnar datorn.
Perplexity har byggt en motsvarande lösning i sin Mac-app. En lokal integritetsspärr letar efter personuppgifter innan något skickas till molnet. Hittar den något kan den behålla innehållet på datorn, maskera uppgifterna eller fråga dig först. Modellen som letar är öppen och finns på Hugging Face.
Anonymisera först, syntetisera sedan.
Prototyper i flera nivåer
Prototyper är inte en sak utan en skala. Inom traditionell UX pratar vi gärna om design i olika nivåer, från enkla skisser (lo-fi) till nästan färdigt (hi-fi). Vilken nivå du väljer beror på vad du vill ta reda på.
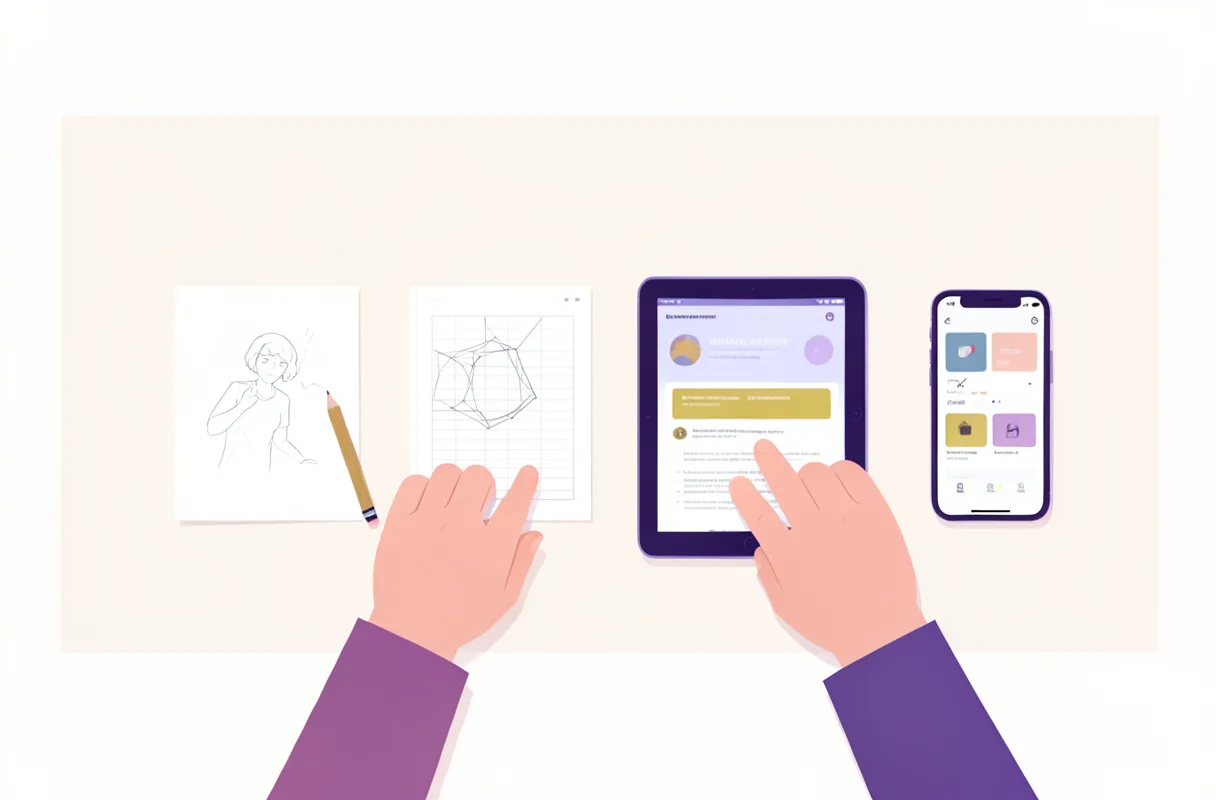
Med AI jobbar vi fortfarande i olika nivåer, men på ett annat sätt. Just nu ser nivåerna ungefär ut så här, men verktygen och arbetssätten ändras fort.
- Snabba iterationer för att göra vägval. Med Matt Pococks
/prototype, eller med design- och artifact-skills, tar agenten fram flera koncept på kort tid. I Claude Code ritar/designkoncepten som artboards (separata ritytor) på en canvas och publicerar dem som en Claude Design-artifact, en egen webbsida som går att dela och kommentera. Slides och Docs fungerar på samma sätt: de är mallar som du startar en artifact från. Du jämför riktningar sida vid sida, itererar och väljer spår innan något byggs på riktigt. - Kodade prototyper. När du behöver känna på ett produktkoncept och inte bara se det, bygger agenten det i kod, med riktig interaktion och logik som går igenom de svåra fallen. Prototypen är fortfarande fristående och lätt att kasta.
- Varianter i den riktiga produkten. Agenterna bygger varianter direkt i produkten, var och en i sin egen worktree (en separat arbetskopia av koden). Upplägget är detsamma som i förra artikeln, där en orkestrator delar ut tickets till agenter som bygger parallellt. Skillnaden är att varje agent här bygger en egen variant av samma sak. Användaren möter något som ser ut och beter sig som produkten, inte en skiss.
- Nya produktspår med mockad data. Ett helt nytt spår behöver inte vänta på backend, integrationer eller riktig data. Agenterna bygger flödet med påhittad data som är realistisk nog att testa på användare. Håller spåret byggs det på riktigt. Håller det inte har du lärt dig det utan att tappa förtroende hos kunder och användare.
Nivåerna har olika syften och behöver olika mycket granskning. De lägre passar när du utforskar designkoncept och gör vägval tillsammans med teamet. De är kortlivade, så där kan du jobba friare och klara dig utan granskning. De högre passar för användningstester och observationer, där användaren behöver möta något som beter sig som produkten. En prototyp som ska testas på användare och leva ett tag är värd lite fler tokens (alltså lite mer AI-användning) på granskning, så att den håller ihop genom hela testet. Eftersom agenterna kan jobba parallellt går det att ta fram flera varianter på varje nivå samtidigt.
Det agenten inte ska göra är att spela användare. Syntetiska personas, alltså AI som låtsas vara användare, generaliserar när de har dålig kontext och svarar utifrån vad en AI-modell tror att användare skulle säga. Men det är vad riktiga användare säger och gör som du behöver ta reda på. Samtalen med riktiga människor, och omdömet om vad de betyder, ligger kvar hos dig.
Däremot fungerar det mycket bra att bygga agenter, skills och data på riktig research om användargruppen, och använda den som utgångspunkt i produkt- och designbeslut. En agent som känner målgruppen från riktiga intervjuer och observationer kan granska ett förslag mot det vi har lärt oss, i stället för mot det en modell killgissar fram.
Från kundinsikter till beslut
/grill-with-docs lägger mycket av arbetet i början. Den vill ha besluten på plats innan något byggs, och det passar när du vet vad du ska bygga. När du utforskar med prototyper kan du använda den på ett annat sätt. I stället för att noga svara på varje fråga utgår du från agentens förslag på svar och itererar dig fram visuellt. Det blir en avvägning: hur mycket vill du svara på i början, hur mycket längs vägen och hur mycket är du beredd att göra om?
När du sedan har en prototyp som du har itererat på, testat med användare och lärt dig av, kör du /grill-with-docs igen, med ett annat perspektiv. Frågorna blir ungefär desamma, men nu är de lättare att svara på. Svaren kommer från kundinsikterna och inte från gissningar.
Kom ihåg: när du utforskar är jobbet att ta reda på vad du inte ska bygga. Mycket av det du tar fram kommer att kastas, och det är meningen. Varje idé du slänger nu är något du slipper bygga, underhålla och förklara för användarna senare.
Nästa steg
Nu vet du hur du tar reda på vad som är värt att bygga. I nästa artikel i serien går vi in på hur vi samlar kundinsikter, produktkunskap och beslut i repot, och varför vi låter koden vara källan till sanning.
Ja, vi har skrivit den här tillsammans med Claude. Det vore lite märkligt annars, men vi vet vad vi vill säga, och har läst, petat och ratat tills formuleringarna, åsikterna och valen är våra.