Sluta vibekoda, jobba med agentisk produktutveckling och loopar istället
En AI-agent som bedömer sitt eget arbete godkänner det gärna. Två agenter som granskar varandra hittar mer. Så här bygger vi loopar i ett orkestreringsverktyg som Orca, där en orkestrator styr agenter som bygger, granskas och frågar i stället för att gissa.
De flesta som jobbar med AI-agenter hamnar i samma mönster. Du skriver en prompt, tittar på resultatet, skriver en ny prompt och tittar igen. Det fungerar, men det är du själv som är loopen. Varje varv kräver att du sitter där.
Nästa steg är att låta agenterna sköta varven själva. En bygger, en annan granskar, och du kliver bara in vid de beslut du vill fatta själv, som en riktning eller något annat du inte vill lämna över till modellen. Det är vad vi menar med agentiska loopar. Just nu bygger vi dem i ett orkestreringsverktyg som heter Orca, men verktygen ändras fort. Orca och de andra verktygen vi använder hittar du i Verktygslådan.
En agent som bedömer sitt eget arbete godkänner det gärna. Dela upp rollerna: en orkestrator planerar och bedömer, andra agenter bygger i vågor, och loopen går tills resultatet uppfyller kriterierna.
Beslut som agenten inte kan ta blir frågor, inte gissningar. De hamnar hos dig, och du tar dem samlat. Allt det här går att köra på vanliga abonnemang, utan API-nycklar.
Från vibe coding till agentic engineering
Vibe coding är att prompta tills något fungerar. Det går fort, och ovanför marken ser resultatet ofta bra ut. Men under ytan växer snabbfixar, trasslig struktur och kod som bara fungerar på något sätt. Det märks först när du ska bygga vidare. För prototyper där koden ändå ska slängas fungerar vibe coding däremot bra. Vi återkommer till olika typer av prototyper längre fram i artikelserien.
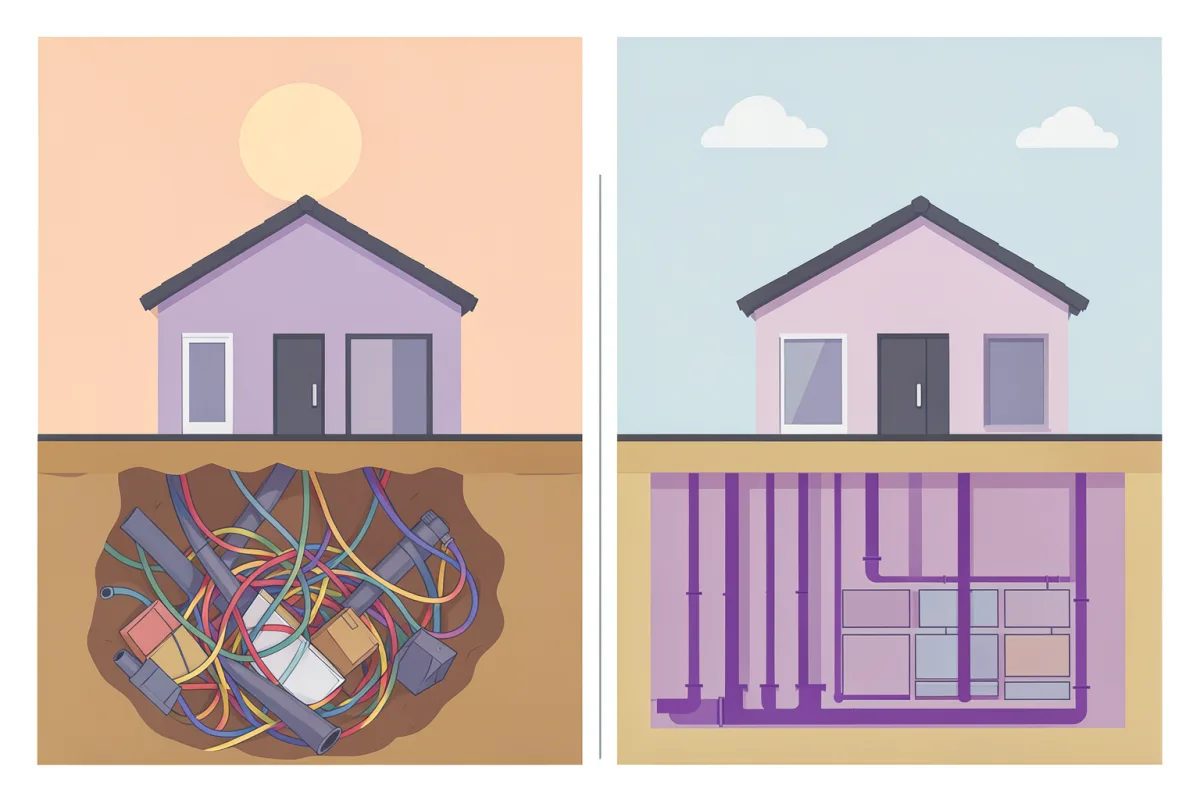
Agentic engineering är samma verktyg med ett arbetssätt runt dem. Matt Pocock har paketerat ett sådant som skills, och vi använder det som ryggrad i våra loopar.
Allt börjar i effekten. Innan vi skriver en rad spec bestämmer vi vad arbetet ska förändra: vilket beteende hos vilka användare, och hur vi ser att det hänt. Utan det blir även den bästa loopen en snabbare funktionsfabrik, som levererar det som står i specen utan att fråga om det gör någon skillnad. Effekten följer sedan med genom hela loopen.
Grunden under loopen
Loopar bygger på några enklare byggstenar, och de är värda att ha på plats först:
CLAUDE.mdär en fil i roten av projektet som Claude Code läser vid varje start. Där står vad projektet är, hur du vill jobba och vilka kommandon som gäller, så att du slipper upprepa det i varje prompt.- Skills är instruktioner i en markdown-fil som agenten kan köra. De flesta kommandon i den här modulen är skills.
- Plan mode låter agenten planera innan den bygger. Hos oss har
/grill-metill stor del ersatt det, eftersom agenten då frågar ut dig innan planen skrivs. - Subagenter tar hand om research och granskning i en egen kontext, så att huvudsessionen håller sig ren.
/goalär det enklaste sättet att låta Claude Code loopa på egen hand. Du skriver vad som ska vara sant när arbetet är klart, och efter varje varv kollar en separat modell om det stämmer. Agenten fortsätter tills villkoret är uppfyllt eller tills den bedömer att det inte går.
Är du ny på Claude Code kan du börja med Verktygskartan och Ditt första AI-arbetsflöde. Hur vi själva gick över till Claude Code berättar vi i Från Lovable till Claude Code, och vad vi tog med oss från Lydia Hallies workshop.
Grundflödet är fem steg:
/grill-with-docs. Agenten intervjuar dig om planen, fråga för fråga, tills den är skarp och det är tydligt vilken effekt arbetet ska ge. Samtidigt skrivs beslut och begrepp ner som dokumentation./to-spec. Samtalet blir en spec med problem, lösning och användarberättelser. Ingen ny intervju, bara en sammanställning av det ni redan kommit fram till./to-tickets. Specen delas upp i små, kompletta delar som går att bygga och verifiera var för sig. Varje ticket anger vilka andra tickets den väntar på./implement. En agent bygger en ticket i taget, testar löpande och committar./code-review. Arbetet granskas mot specen och effekten innan det går vidare.
Runt grundflödet använder vi några skills ofta:
/wayfinderför arbete som är för stort för en enda session. Den lägger en karta av beslutstickets i ärendehanteringen och löser dem en i taget, tills vägen fram är tydlig. Där planerar du, utan att bygga. När det börjar klia i fingrarna att bara sätta igång är det oftast ett tecken på att kartan är klar./prototypenär ett beslut behöver något att ta på. Agenten bygger en kastbar prototyp som svarar på en fråga: flera radikalt olika UI-varianter att växla mellan, eller en enda delbar HTML-fil som kör en logik igenom de svåra fallen./researchnär vi behöver fakta. En agent i bakgrunden läser primärkällor, som officiell dokumentation och källkod, och sparar fynden med källor i repot.
Nytt i version 1.3
I början av oktober kom version 1.3 av Matts skills, en riktigt trevlig uppdatering som han går igenom i en video. Tre nya skills passar rakt in i hur vi jobbar:
/implement-specbygger en hel spec. Den läser ticketsen som en uppgiftsgraf, alltså en karta över vad som väntar på vad, och startar subagenter på allt som är redo. Varje subagent bygger i en egen worktree (en separat arbetskopia av koden). Arbetet slås ihop på en gemensam gren, och när fler tickets blir redo fyller den på med nya agenter. Till sist granskas allt med/code-review. Det är alltså en agentisk loop, paketerad som en skill./prskriver PR-beskrivningar, alltså texten som följer med en kodändring till granskning. De är gjorda för att granskas, med bevis och en bedömning av risken. Mer om den nedan./retrogör en retro på en session. Agenten går igenom vad som tog tid eller blev fel och föreslår förbättringar av sin egen miljö, som nya automatiska kontroller, tydligare kodstandarder eller bättre vägvisning i koden.
Så hänger det ihop med våra loopar
Steg 1 och 2 gör du tillsammans med agenten. Det är där besluten fattas, med effekten som måttstock. /prototype och /research ger underlag till besluten. Steg 3 ger uppgifterna och beroendena.
Sedan tar loopen över. Det /implement-spec gör är i grunden samma sak som vi redan gör med /orchestration i Orca, fast med subagenter i stället för separata agenter. /implement-spec kör allt inom en session, där subagenterna numera själva kan starta nya subagenter. /orchestration skapar i stället parallella arbetsytor i Orca, var och en med en egen worktree och en egen agent, och varje agent kan köra en annan modell.
Vi håller fortfarande på att ta reda på hur de två passar bäst ihop. Båda är loopar över en uppgiftsgraf, och vilken som passar beror på hur stort arbetet är och hur mycket vi vill kunna följa och styra varje del. Vi provar dem också tillsammans med deterministiska loopar, alltså kodade skript som kör samma steg på samma sätt varje gång.
Claude har också egna motsvarigheter till /orchestration. I agent teams leder en Claude Code-session ett team av andra sessioner, som delar en uppgiftslista och skickar meddelanden till varandra. Senast har Anthropic gjort om Projects. Ett projekt blir en löpande konversation, där en koordinator fördelar arbetet på parallella trådar. Varje tråd är en Claude Code-session i molnet med en egen gren, och den startar med projektets filer, repon, instruktioner och minne. Arbetet fortsätter när du stänger datorn, och det går att styra från telefonen. De nya Projects utforskar vi just nu i beta.
Granskningen är flaskhalsen
När agenterna bygger snabbare flyttar flaskhalsen till granskningen. Någon måste fortfarande förstå vad som har ändrats och bedöma om det är säkert att släppa. Där gör /pr mest nytta.
Det viktigaste i skillen är riskbedömningen. Matt liknar varje ändring vid en dörr. Genom vissa dörrar kan du gå tillbaka: blir det fel tar du bort ändringen och allt är som förut. Andra går bara åt ett håll, till exempel när data raderas eller något redan har nått användarna. Därför ställer skillen två frågor: Går ändringen att ta tillbaka? Och hur mycket annat kan påverkas om något blir fel?
Svaret avgör hur ändringen behöver granskas och testas. Går den att backa och påverkar lite räcker en snabb genomläsning. Går den inte att ta tillbaka och påverkar mycket behöver den granskas noga och testas ordentligt. Då lägger du din egen tid där den gör skillnad.
Bevisen gör också nytta. När agenten ska visa före och efter måste den faktiskt köra ändringen, så du vet att det fungerar och inte bara att agenten tror det.
Varför en modell inte räcker
Det enklaste sättet att få en agent att iterera, eller loopa, är att be den göra det: “Ta en screenshot, jämför med skissen, fortsätt tills det ser rätt ut.” Det ger ofta mycket bättre resultat än en enda körning, och det är en bra grund.
Problemet är att samma modell med samma kontext har svårt att se sina egna misstag. Den minns varför den gjorde som den gjorde, och det resonemanget färgar bedömningen. Resultatet blir att den godkänner saker som en utomstående hade reagerat på.
En granskare med ren kontext ser bara resultatet och kriterierna. Är granskaren dessutom en annan modell får du en verklig second opinion, med andra styrkor och andra blinda fläckar. Därför låter vi aldrig samma agent både bygga och godkänna sitt eget arbete.
/goal är ett första steg åt det hållet. Där är det en separat modell som efter varje varv avgör om du är framme, inte den som gör jobbet. Men den granskar inte själva resultatet. Den läser bara det som syns i konversationen, som ett testresultat, och kör inga kontroller själv. För en riktig granskning behövs en egen granskare.
Så kör vi loopen i Orca
Du kan koppla ihop agenter med skript och terminalfönster, men det blir snabbt rörigt. Vem jobbar med vad? Är agenten klar, eller har den fastnat? Ett orkestreringsverktyg håller ordning på det.
Arbetet går i två loopar. I den första designar och definierar vi vad som ska göras, med kundinsikter, /grill-with-docs, /to-spec och prototyper, och avslutar med /to-tickets. När vi vet vad som ska göras tar den andra loopen över och bygger det. Det är där Orca kommer in.
Vi startar den med Orcas /orchestration. En agent blir orkestrator och delar ut ticketsen till andra agenter, workers, som kör /implement på varsin del. Orkestratorn gör fyra saker:
- Spinner upp så många agenter som behövs. Antalet är inte bestämt i förväg. Det avgörs av uppgiften.
- Grupperar tickets i vågor. Det som hör ihop byggs i samma våg, ofta i samma worktree. Annars får agenterna egna worktrees, så att de inte skriver över varandra. En ticket som väntar på en annan startar först när den är klar, resten körs parallellt.
- Tar emot och bedömer resultatet. När en worker är klar startar orkestratorn en egen worker som kör
/code-reviewpå arbetet, så att ingen granskar sitt eget arbete. Granskaren rapporterar lyckat eller misslyckat, plus en kort sammanfattning. Orkestratorn bestämmer sedan vad nästa våg ska innehålla, eller om något behöver göras om. - Svarar på frågor. En worker som stöter på något den inte kan avgöra frågar orkestratorn och väntar. Orkestratorn svarar själv eller skickar frågan vidare till dig.
Det sista är viktigare än det låter. Det vanligaste skälet till att agentiska flöden spårar ur är att agenten gissar på ett beslut, bygger vidare på gissningen och tre varv senare står du med något helt annat än du ville ha.
Vad loopen bygger varierar. Ofta är det en prototyp. Det kan också vara en draft-PR till produktion som en utvecklare granskar. Då skriver /pr beskrivningen, med en riskbedömning som visar hur noga ändringen behöver granskas. Granskningen är fortfarande flaskhalsen, så loopen ska lämna ifrån sig något som är lätt att granska.
Det som gör loopen bra:
- Effekten och kriterierna finns innan bygget börjar. De kommer från specen och ticketsen, så att både de som bygger och de som granskar bedömer mot något konkret, inte mot en känsla.
- Rätt modell på rätt plats. Den tunga modellen gör planeringen och bedömningen, där omdömet spelar störst roll. En lokal modell gör det mesta av implementationen, där det handlar om volym.
- Loopen har ett tak. Går något inte att få godkänt efter ett par försök lyfts det till dig. Då är det oftast ticketen eller kriterierna som behöver ses över, inte koden.
Vi blandar modeller
Varje modell har sina egenskaper, och en orkestrerad loop gör det enkelt att dra nytta av dem. Varje worker i Orca kör sin egen agent med sin egen modell. Därför väljer vi modell per uppgift i stället för per projekt, alltid utifrån uppdraget och kundens AI-policy. Så här ser mixen ut just nu:
- Claude Code är basen. Opus 5.5 är vår daily driver och sköter orkestreringen. Fable 5.1 tar vi till för research och dialoger, och när det handlar om resonemang, strategi och analys.
- Codex ger oss OpenAI:s modeller Astra och Sol, alltså en annan agent och ett annat perspektiv. Vi använder dem mycket mindre sedan Opus 5.5 kom, men det är värdefullt att ha dem till hands.
- Pi kör vi som agent med en lokal modell via MLX Serve. Den gör främst implementation och sparar mycket tokens, och för känsligare uppgifter lämnar koden aldrig datorn. Baksidan är att det kan ta längre tid, och att många parallella agenter kräver mycket prestanda av datorn.
Det viktigaste med mixen är att vi inte är inlåsta hos en viss leverantör. Att enkelt kunna byta håller AI-leverantörerna konkurrensutsatta. När en ny modell kommer, eller en befintlig blir bättre på något, byter vi in den i den del av loopen där den gör mest nytta. Resten av loopen fortsätter som förut.
Allt det här går att köra på vanliga abonnemang, utan API-nycklar. Kodagenterna använder ditt befintliga konto och orkestreringsverktyget styr dem som vilka terminalprogram som helst, så du betalar inte per anrop. Agenterna, modellerna och verktygen för lokala modeller hittar du i Verktygslådan.
Beslut i en loop
Det mesta av osäkerheten tar vi bort innan bygget börjar, med /grill-me. Den frågar ut dig tills antagandena har svar. Det är därför den är så kraftfull: den tvingar fram svar på det som annars hade blivit gissningar.
Agenterna har också blivit bättre på att fråga när något är oklart. Kan en worker inte avgöra något under bygget frågar den orkestratorn, och de frågor som är dina att svara på når dig. Det är vår version av “human in the loop”. Det handlar inte om att någon godkänner varje steg, utan om att du fattar de beslut du vill behålla kontrollen över.
Ett bra sätt att ta de besluten är med artifacts i Claude Code. Frågorna som når dig publiceras då som en egen webbsida. Med design- och artifact-skills gör vi dem konkreta, med skisser, alternativ och konsekvenser sida vid sida. Då blir det lätt att välja det som ger störst effekt och inte bara det som är snabbast att bygga. Du kommenterar och sätter riktningen, och svaren går tillbaka till agenten som bygger vidare utifrån dem. Du styr utan att behöva sitta med i varje varv.
Att börja
Börja litet. Du behöver inte bygga hela flödet första gången.
- Välj något avgränsat, som en komponent eller en sida, och bestäm vad den ska förändra för användarna.
- Beskriv vad som ska vara sant när den är klar. Några korta meningar räcker, gärna med en referensbild. Det är dina kriterier.
- Starta med
/goaloch använd kriterierna som villkor. Sätt ett tak, till exempel “eller sluta efter tre varv”. - Titta på resultatet och iterera där det inte blev som du tänkt dig.
- När det sitter kan du låta en orkestrator ge uppgiften till en worker, och en annan worker granska resultatet mot kriterierna.
Det är resultatet du lär dig mest av. Det visar ganska ärligt vilka frågor du inte har svarat på.
Verktygen vi använder för det här, och allt annat vi jobbar med, finns samlade i Verktygslådan. Det rör sig snabbt, så listan uppdateras löpande.
Nästa steg
I nästa modul tror vi att vi går från att bygga saker rätt till att bygga rätt saker: hur agentiska loopar kan hjälpa till med research, kundinsikter och prototyper, och varför det viktigaste ofta är att ta reda på vad du inte ska bygga. Men saker ändras snabbt, så det kan bli något annat.
Egentligen hade vi tänkt skriva om något helt annat i den här modulen, men det har hänt mycket sedan förra. Därför valde vi att skriva om agentiska loopar i produktutveckling i stället. De har gjort vårt arbetssätt bättre många gånger om.
Ja, vi har skrivit den här tillsammans med Claude. Det vore lite märkligt annars, men vi vet vad vi vill säga, och har läst, petat och ratat tills formuleringarna, åsikterna och valen är våra.